
当前通用大模型(依托海量公开数据训练)在纪检监察领域应用中,普遍存在专业术语运用不标准、法条引用混乱、业务逻辑契合度不足、案例推送不精准、违纪定性偏差、主观臆断过多等突出问题,无法满足纪检监察办案严谨、客观、规范的工作要求。核心症结在于缺少适配纪检监察专属语境的训练数据支撑。对此,通过系统性构建百万级执纪指令数据集,精准对齐纪检监察业务语言范式、工作流程和执纪标准,能够有效推动通用大模型向纪检监察专属领域模型迭代升级,为信访、监督、审调、审理、巡察等核心业务场景提供坚实技术支撑。
打造高质量执纪指令数据集,核心不是简单堆砌行业文本,而是以真实执纪业务场景为导向,构建结构化、标准化、场景化的指令训练样本,让大模型深度学习纪检监察工作的思维逻辑、专业术语、行文规范和执纪标准,从根源上解决通用模型“不专业、不贴合、不合规”的应用短板。
百万级执纪指令数据集构建坚持全覆盖、重合规、高精准原则,全面覆盖纪检监察核心业务领域,科学划分十大业务任务模块,统筹规划数据样本配比,整体数据体量稳定突破百万条。数据集涵盖法规条文解读、问题线索处置、审查调查实操、案件审理研判、纪检文书编撰、谈话问询提纲、信访举报处置、专项监督检查、纪律定性案例分析等全场景业务内容,全面匹配日常执纪办案、监督履职、公文处理等工作需求。所有样本均采用“指令-输入-输出”结构化模式搭建,清晰对应具体业务任务、场景素材和规范输出结果,同时标注业务领域、纪律类型、风险等级等关键维度,实现数据标准化、可溯源、可迭代。
数据集构建严格遵守保密管理规定,杜绝直接使用原始涉案卷宗材料,所有数据均经过脱敏重构、去标识化处理,全程在私有化环境下闭环运作。数据素材主要依托党纪国法、官方政策解读、权威典型案例、标准化业务教材等公开合规资源,同时结合一线纪检监察业务专家办案实操,仿真重构各类业务场景样本,隐去人员、单位、地点、金额等敏感信息。针对内部脱密办结文书、业务问答素材,通过句式改写、要素重构、内容优化等方式二次加工,既保留真实办案逻辑,又彻底规避涉密风险。同时专门搭建负样本数据库,收录法条错引、定性偏差、表述不规范等问题案例,助力模型纠错纠偏,提升输出精准度。
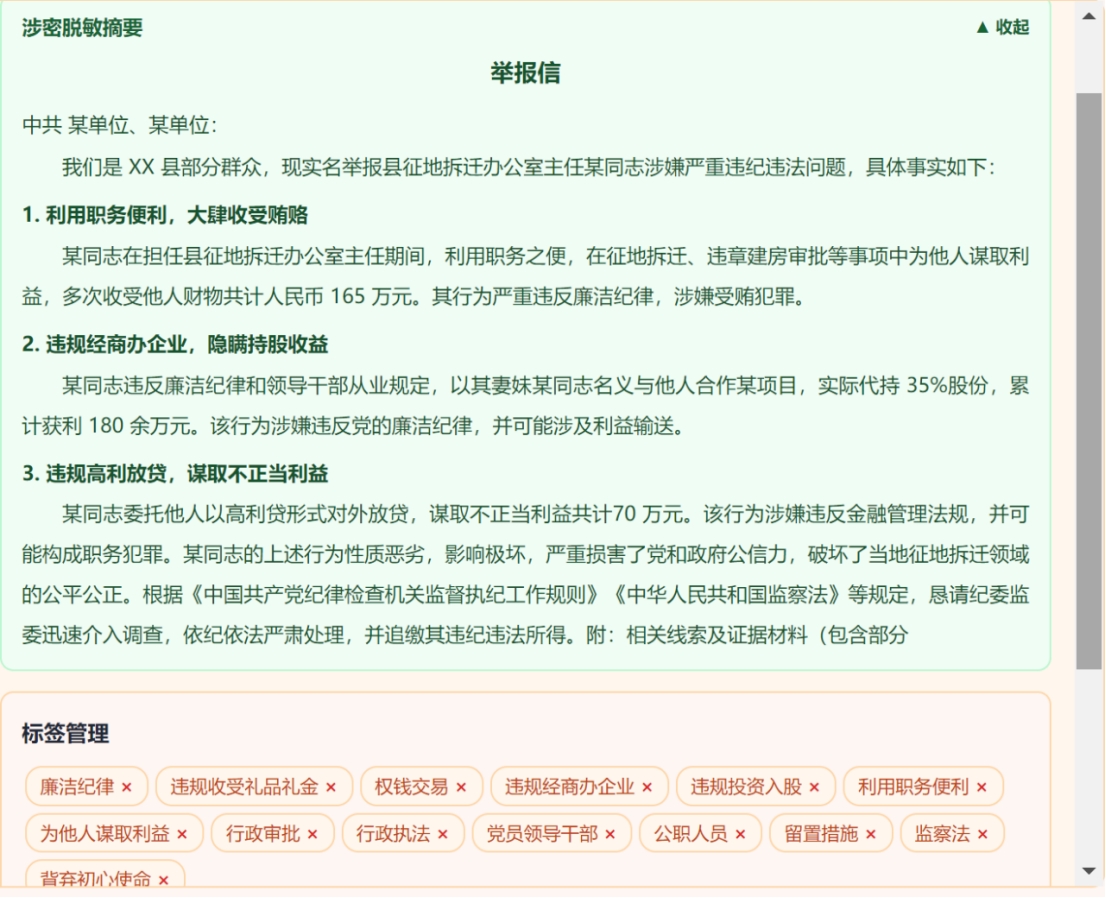
为彻底扭转通用大模型语言风格不贴合纪检监察工作的问题,数据集建设全程锚定纪检监察专属语言范式。立足纪检监察工作“客观严谨、依规依纪、表述规范、逻辑严密”的语言特征,搭建专属术语词典,统一六大纪律、办案流程、证据认定、文书制式等专业词汇使用标准,杜绝不规范简称、口语化表述。严格规范行文逻辑,明确事实陈述、法规引用、纪律定性的固定表述顺序,摒弃主观臆断、夸张表述等问题。同时建立负面话术约束库,梳理办案禁止用语、违规讯问表述、错误定性句式,从训练层面约束模型输出行为,适配文书撰写、谈话宣讲、案例研判、政策解读等不同场景的差异化语言风格。
高质量的数据离不开严苛的质量管控体系。本次建设建立机器初筛、专家审核、交叉评审的三级质检机制,对所有入库样本严格把关。通过自动化工具完成数据去重、敏感词筛查、语句合规性校验,再由资深纪检业务专家逐批次核查样本的法条适用性、定性准确性、表述规范性,按照百分制完成质量评级,仅优质样本可入库使用。同时实行数据版本化管理,全程记录数据新增、修改、剔除情况,保障数据集持续迭代、有据可查。
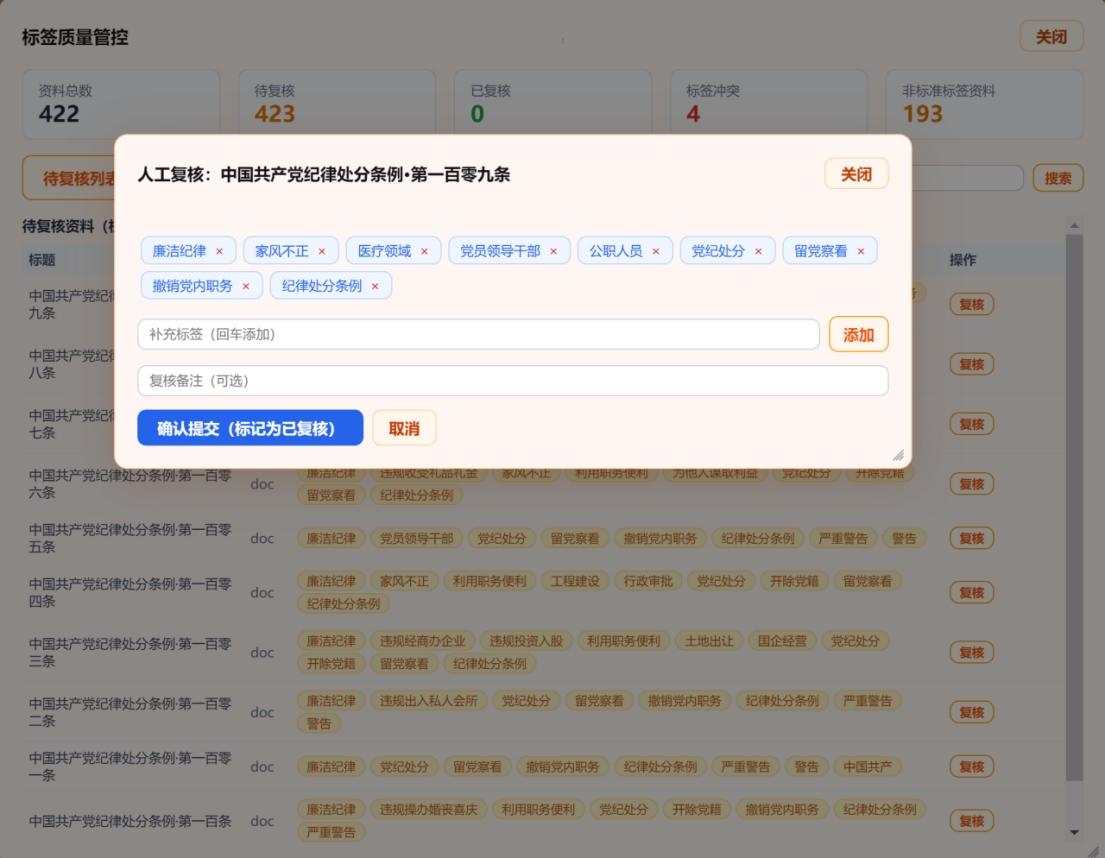
依托百万级执纪指令数据集,采用轻量化微调结合人工偏好对齐的训练方式,可快速完成通用大模型的领域适配优化。经过专项训练的大模型,能够熟练掌握纪检监察专业业务逻辑和规范语言范式,有效提升法规检索、线索研判、违纪定性、案例推送等工作的精准度,大幅减少模型幻觉、法条错用、定性失当等问题。并可持续结合新规新政、新型违纪行为、专项监督重点,动态更新扩充数据集,持续优化模型业务适配能力,让人工智能技术深度融入纪检监察履职全过程。
